2026
Learning from the Self-future: On-policy Self-distillation for dLLMs
Yifu Luo*, Zeyu Chen*, Haoyu Wang, Xinhao Hu, Yuxuan Zhang, Zhizhou Sha, Shiwei Liu (* equal contribution)
Preprint 2026
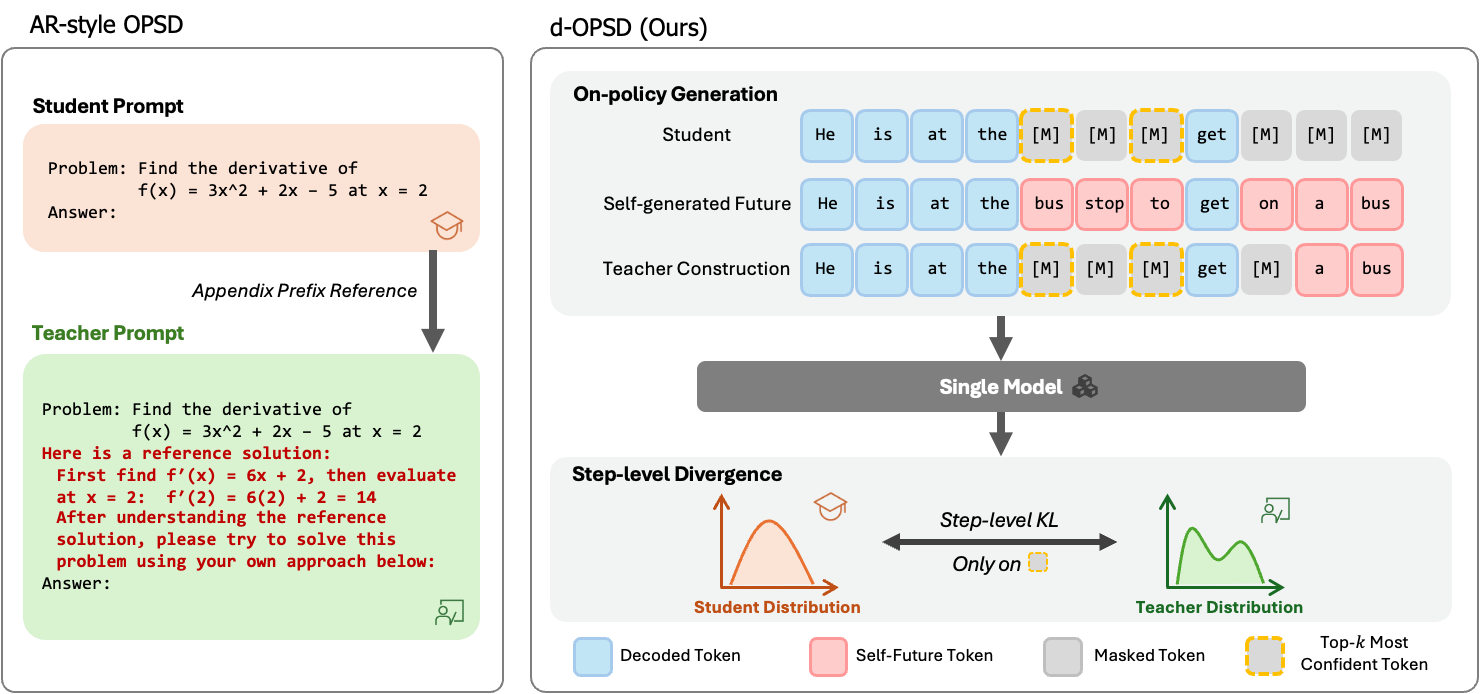
Propose the first OPSD approach for dLLMs. We reframe the OPSD formulation from prefix conditioning to the selfsuffix generation conditioning tailored specifically for dLLMs. We also shift dense supervision from the token-level to steplevel, aligning training with the iterative denoising nature of dLLMs.
Learning from the Self-future: On-policy Self-distillation for dLLMs
Yifu Luo*, Zeyu Chen*, Haoyu Wang, Xinhao Hu, Yuxuan Zhang, Zhizhou Sha, Shiwei Liu (* equal contribution)
Preprint 2026
Propose the first OPSD approach for dLLMs. We reframe the OPSD formulation from prefix conditioning to the selfsuffix generation conditioning tailored specifically for dLLMs. We also shift dense supervision from the token-level to steplevel, aligning training with the iterative denoising nature of dLLMs.
No Hidden Prompts Needed! You Can Game AI Peer Review with Presentation-Only Revisions
Xu Yang, Zhizhou Sha, Junbo Li, Jian Yu, Yifan Sun, Matthew Zhao, Jinrui Fang, Xinyue Guo, Yining Wu, Xu Hu, Yifu Luo, Qiang Liu, Zhangyang Wang
Preprint 2026
An interesting work on AI-generated reviews, with analysis insights revealed, a benchmark, and a framework.
No Hidden Prompts Needed! You Can Game AI Peer Review with Presentation-Only Revisions
Xu Yang, Zhizhou Sha, Junbo Li, Jian Yu, Yifan Sun, Matthew Zhao, Jinrui Fang, Xinyue Guo, Yining Wu, Xu Hu, Yifu Luo, Qiang Liu, Zhangyang Wang
Preprint 2026
An interesting work on AI-generated reviews, with analysis insights revealed, a benchmark, and a framework.
Power Reinforcement Post-Training of Text-to-Image Models with Super-Linear Advantage Shaping
Haoyuan Sun*, Jing Wang*, Yuxin Song*, Yu Lu, Bo Fang, Yifu Luo, Jun Yin, Pengyu Zeng, Miao Zhang, Tiantian Zhang, Xueqian Wang, Shijian Lu (* equal contribution)
Preprint 2026
Proposed Super-Linear Advantage Shaping (SLAS) to mitigate the normalization issues in the text-to-image RL post-training.
Power Reinforcement Post-Training of Text-to-Image Models with Super-Linear Advantage Shaping
Haoyuan Sun*, Jing Wang*, Yuxin Song*, Yu Lu, Bo Fang, Yifu Luo, Jun Yin, Pengyu Zeng, Miao Zhang, Tiantian Zhang, Xueqian Wang, Shijian Lu (* equal contribution)
Preprint 2026
Proposed Super-Linear Advantage Shaping (SLAS) to mitigate the normalization issues in the text-to-image RL post-training.
Principled RL for Flow Matching Emerges from the Chunk-level Policy Optimization
Yifu Luo*, Haoyuan Sun*, Xinhao Hu*, Penghui Du*, Keyu Fan, Bo Li, Sinan Du, Wan Xu, Zhiyu Chen, Bo Xia, Yongzhe Chang, Changqian Yu, Kun Gai, Tiantian Zhang, Xueqian Wang (* equal contribution)
Forty-Third International Conference on Machine Learning (ICML) 2026
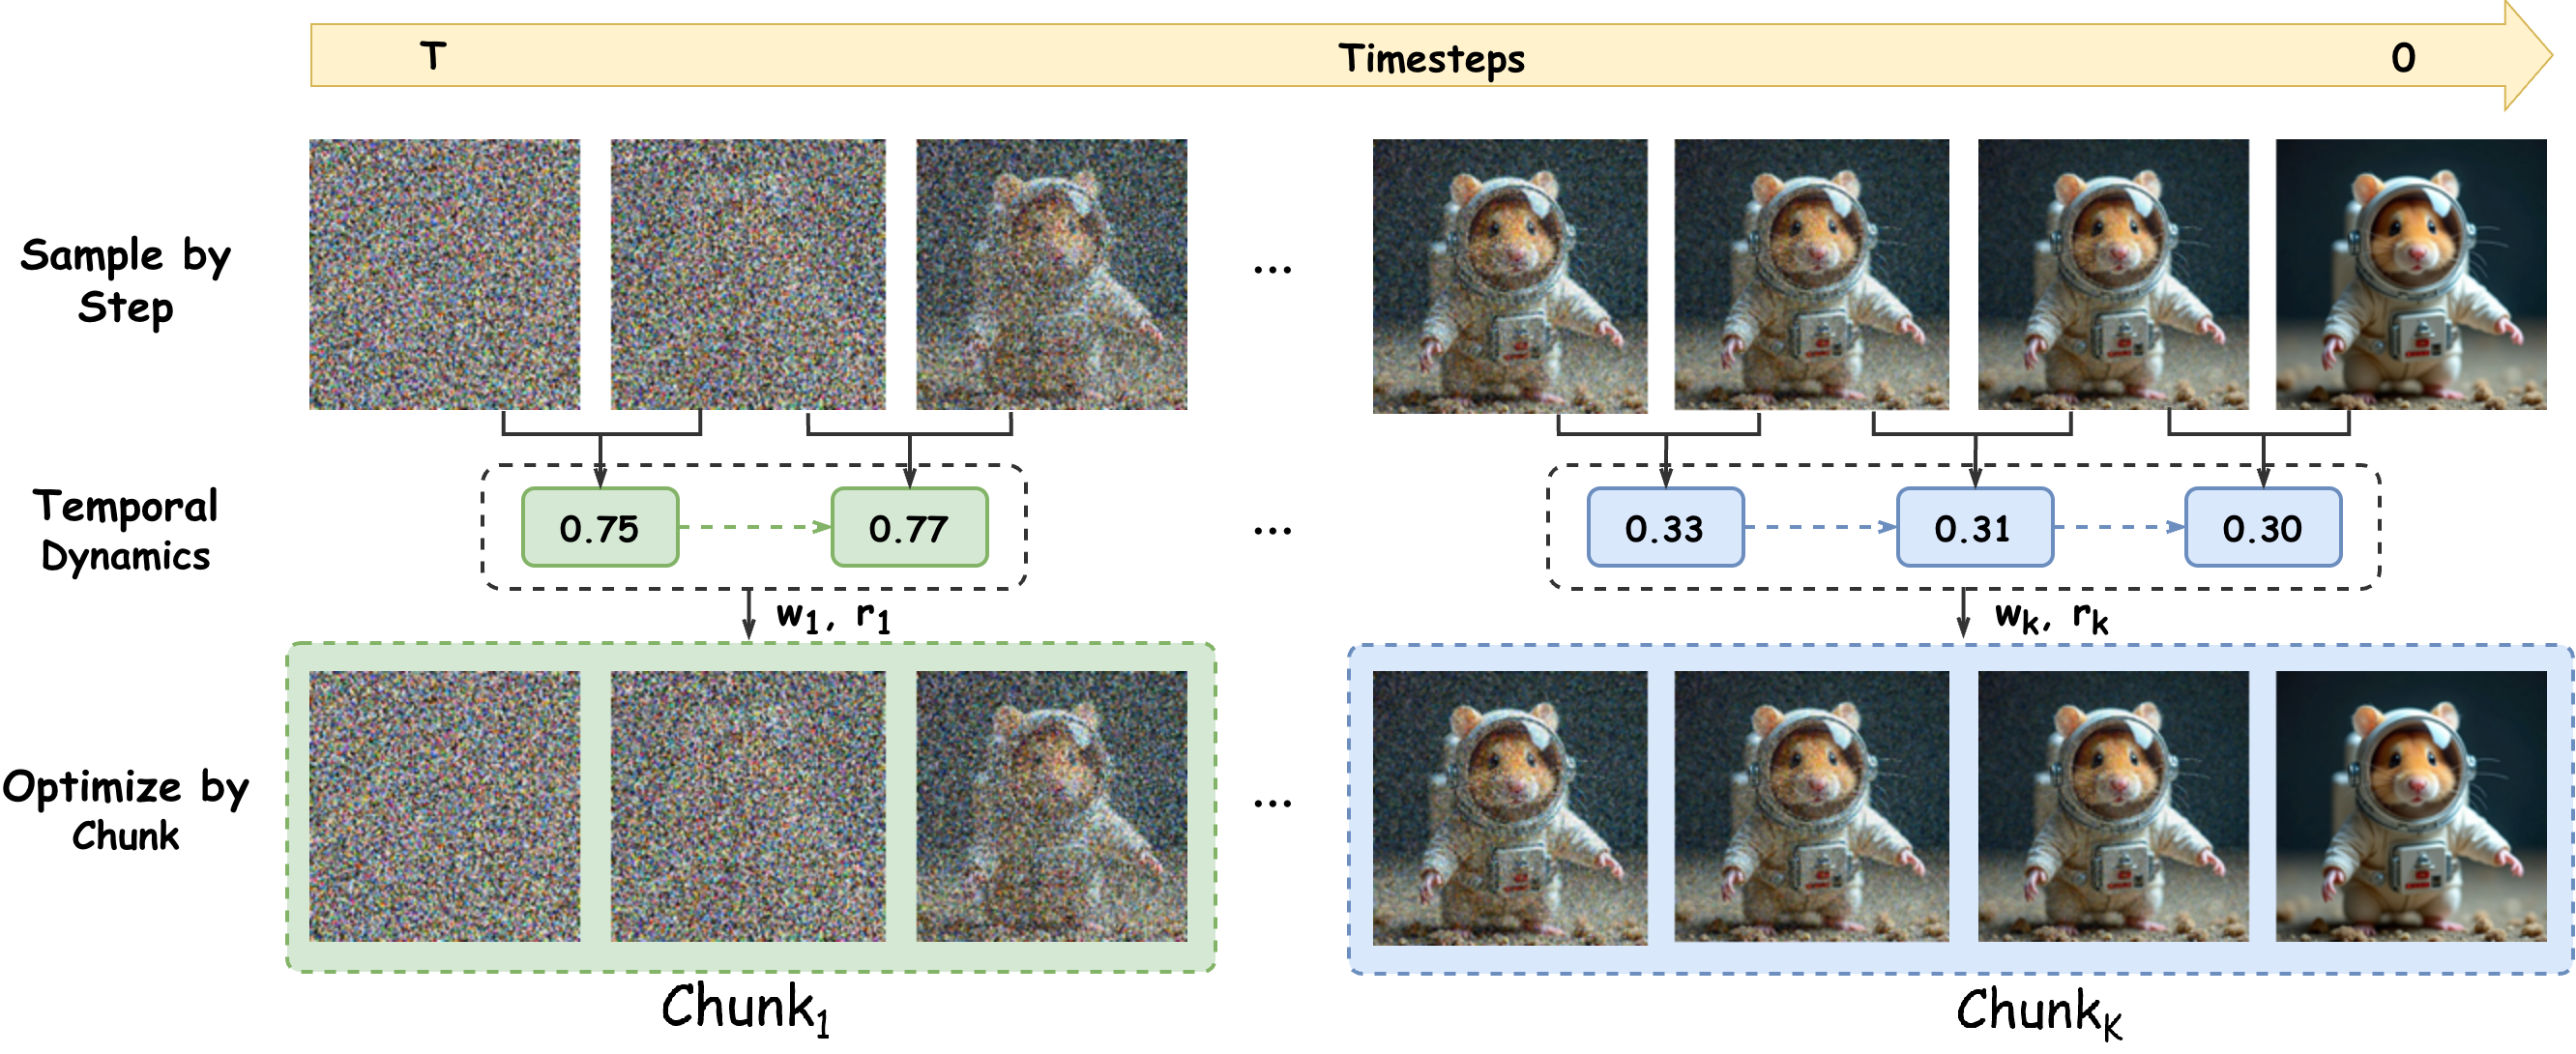
Propose a chunk-level RL optimization for flow-matching text-to-image generation. We shift GRPO from the step-level to the chunk-level, aggregating consecutive steps into a coherent “chunk” to mitigate the sparse rewards bottleneck.
Principled RL for Flow Matching Emerges from the Chunk-level Policy Optimization
Yifu Luo*, Haoyuan Sun*, Xinhao Hu*, Penghui Du*, Keyu Fan, Bo Li, Sinan Du, Wan Xu, Zhiyu Chen, Bo Xia, Yongzhe Chang, Changqian Yu, Kun Gai, Tiantian Zhang, Xueqian Wang (* equal contribution)
Forty-Third International Conference on Machine Learning (ICML) 2026
Propose a chunk-level RL optimization for flow-matching text-to-image generation. We shift GRPO from the step-level to the chunk-level, aggregating consecutive steps into a coherent “chunk” to mitigate the sparse rewards bottleneck.
VQRAE: Representation Quantization Autoencoders for Multimodal Understanding, Generation and Reconstruction
Sinan Du*, Jiahao Guo*, Bo Li, Shuhao Cui, Zhengzhuo Xu, Yifu Luo, Yongxian Wei, Kun Gai, Xinggang Wang, Kai Wu, Chun Yuan (* equal contribution)
The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 2026 12 citations
Propose a quantization version of autoencoders for unified visual tasks for both understanding and generation.
VQRAE: Representation Quantization Autoencoders for Multimodal Understanding, Generation and Reconstruction
Sinan Du*, Jiahao Guo*, Bo Li, Shuhao Cui, Zhengzhuo Xu, Yifu Luo, Yongxian Wei, Kun Gai, Xinggang Wang, Kai Wu, Chun Yuan (* equal contribution)
The IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) 2026 12 citations
Propose a quantization version of autoencoders for unified visual tasks for both understanding and generation.
Calibration Enhanced Decision Maker: Towards Trustworthy Sequential Decision-Making with Large Sequence Models
Haoyuan Sun, Bo Xia, Yifu Luo, Tiantian Zhang, Xueqian Wang
Transactions on Machine Learning Research (TMLR) 2026
Propose a decision-making method for minimizing the state-action marginal distribution distance and enhancing the agent's calibration.
Calibration Enhanced Decision Maker: Towards Trustworthy Sequential Decision-Making with Large Sequence Models
Haoyuan Sun, Bo Xia, Yifu Luo, Tiantian Zhang, Xueqian Wang
Transactions on Machine Learning Research (TMLR) 2026
Propose a decision-making method for minimizing the state-action marginal distribution distance and enhancing the agent's calibration.
2025
Reinforcement Learning Meets Masked Generative Models: Mask-GRPO for Text-to-Image Generation
Yifu Luo*, Xinhao Hu*, Keyu Fan*, Haoyuan Sun*, Zeyu Chen, Bo Xia, Tiantian Zhang, Yongzhe Chang, Xueqian Wang (* equal contribution)
Advances in Neural Information Processing Systems 38 (NeurIPS) 2025 13 citations
Propose the first GRPO approach for masked generative models in text-to-image generation. We redefine the transition probability tailored specifically for masked generative models, and explore several useful strategies to further enhance our method.
Reinforcement Learning Meets Masked Generative Models: Mask-GRPO for Text-to-Image Generation
Yifu Luo*, Xinhao Hu*, Keyu Fan*, Haoyuan Sun*, Zeyu Chen, Bo Xia, Tiantian Zhang, Yongzhe Chang, Xueqian Wang (* equal contribution)
Advances in Neural Information Processing Systems 38 (NeurIPS) 2025 13 citations
Propose the first GRPO approach for masked generative models in text-to-image generation. We redefine the transition probability tailored specifically for masked generative models, and explore several useful strategies to further enhance our method.
Wavelet Fourier Diffuser: Frequency-Aware Diffusion Model for Reinforcement Learning
Yifu Luo, Yongzhe Chang, Xueqian Wang
International Joint Conference on Neural Networks (IJCNN) 2025
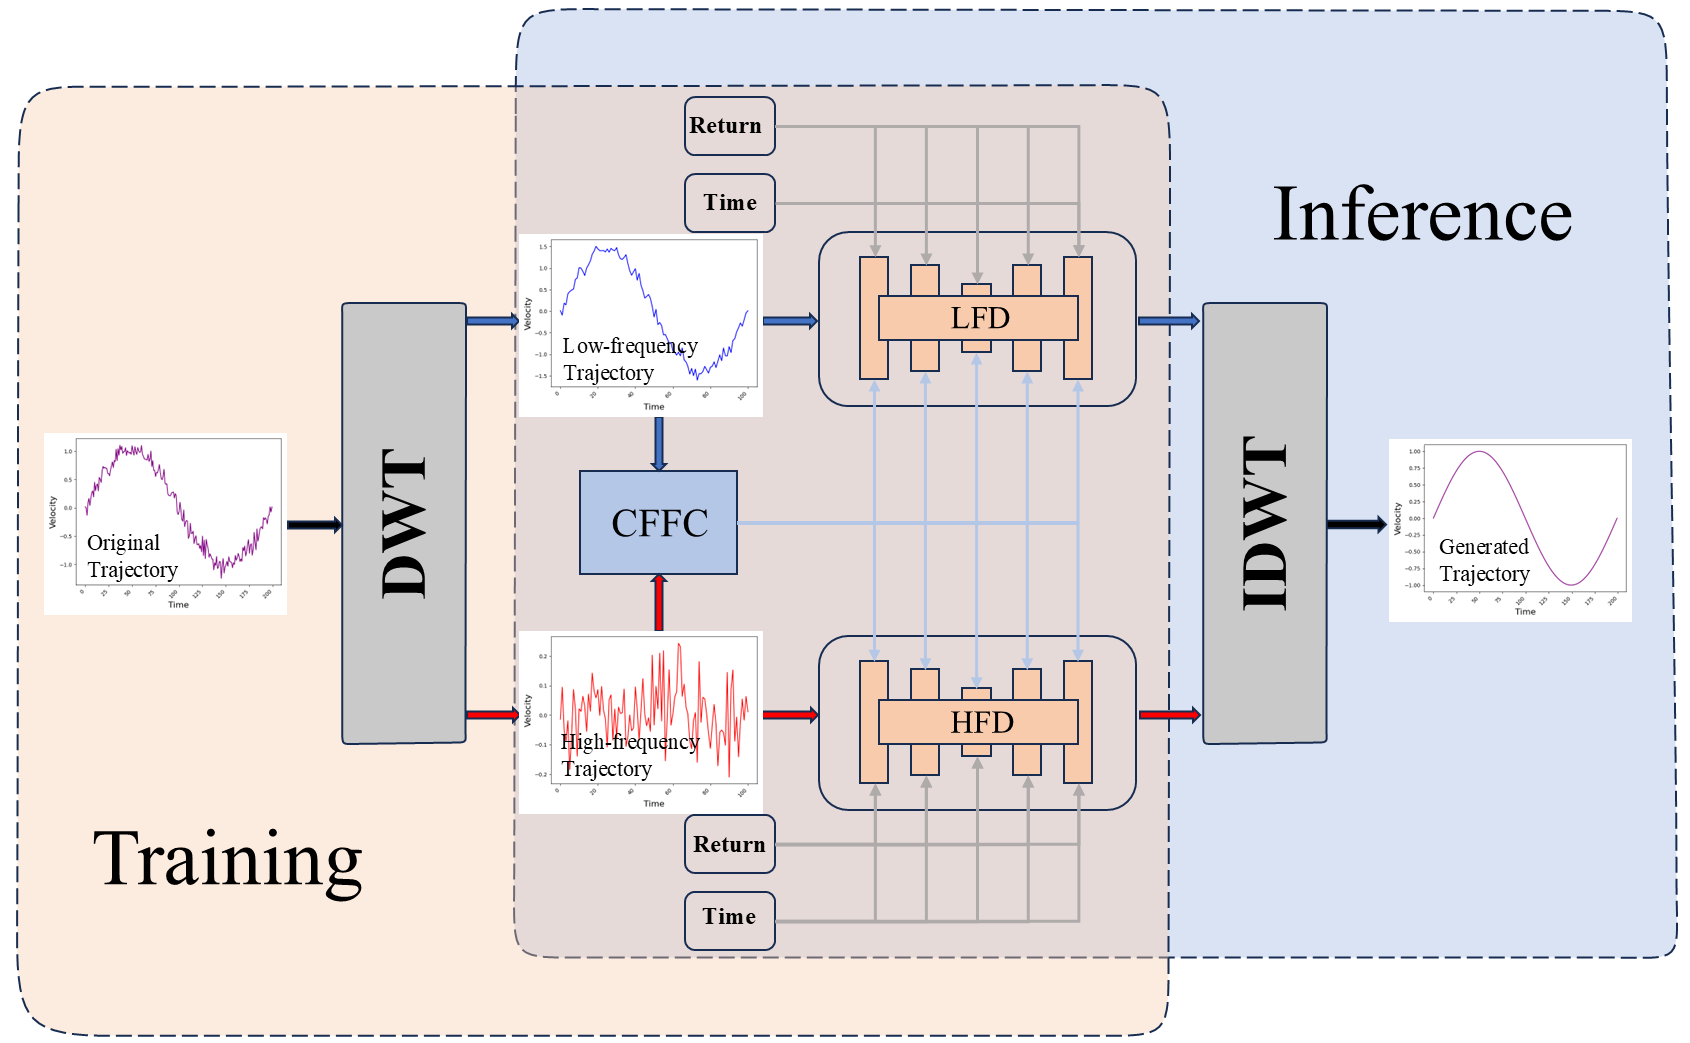
Propose a frequency-aware decision diffuser for offline RL. We introduced frequency analysis into diffusion-based decision making for superior stability.
Wavelet Fourier Diffuser: Frequency-Aware Diffusion Model for Reinforcement Learning
Yifu Luo, Yongzhe Chang, Xueqian Wang
International Joint Conference on Neural Networks (IJCNN) 2025
Propose a frequency-aware decision diffuser for offline RL. We introduced frequency analysis into diffusion-based decision making for superior stability.
Reinforcement Fine-Tuning Powers Reasoning Capability of Multimodal Large Language Models
Haoyuan Sun, Jiaqi Wu, Bo Xia, Yifu Luo, Yifei Zhao, Kai Qin, Xufei Lv, Tiantian Zhang, Yongzhe Chang, Xueqian Wang
Preprint 2025 18 citations
Argue reinforcement fine-tuning powers the reasoning capability of multimodal large language models.
Reinforcement Fine-Tuning Powers Reasoning Capability of Multimodal Large Language Models
Haoyuan Sun, Jiaqi Wu, Bo Xia, Yifu Luo, Yifei Zhao, Kai Qin, Xufei Lv, Tiantian Zhang, Yongzhe Chang, Xueqian Wang
Preprint 2025 18 citations
Argue reinforcement fine-tuning powers the reasoning capability of multimodal large language models.
2024
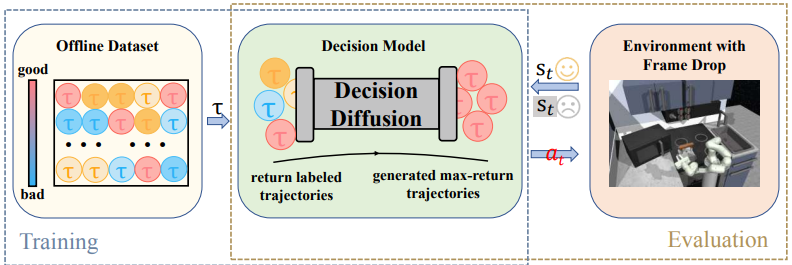
D3D: Conditional Diffusion Model for Decision-Making Under Random Frame Dropping
Bo Xia, Yifu Luo, Yongzhe Chang, Bo Yuan, Zhiheng Li, Xueqian Wang
2024 33rd IEEE International Conference on Robot and Human Interactive Communication (ROMAN) 2024
We propose Conditional Diffusion Model for Decision-Making under Random Frame Dropping (D3D), a decision-diffuser sequential RL approach to solve the frame dropping issue in robotics control.
D3D: Conditional Diffusion Model for Decision-Making Under Random Frame Dropping
Bo Xia, Yifu Luo, Yongzhe Chang, Bo Yuan, Zhiheng Li, Xueqian Wang
2024 33rd IEEE International Conference on Robot and Human Interactive Communication (ROMAN) 2024
We propose Conditional Diffusion Model for Decision-Making under Random Frame Dropping (D3D), a decision-diffuser sequential RL approach to solve the frame dropping issue in robotics control.